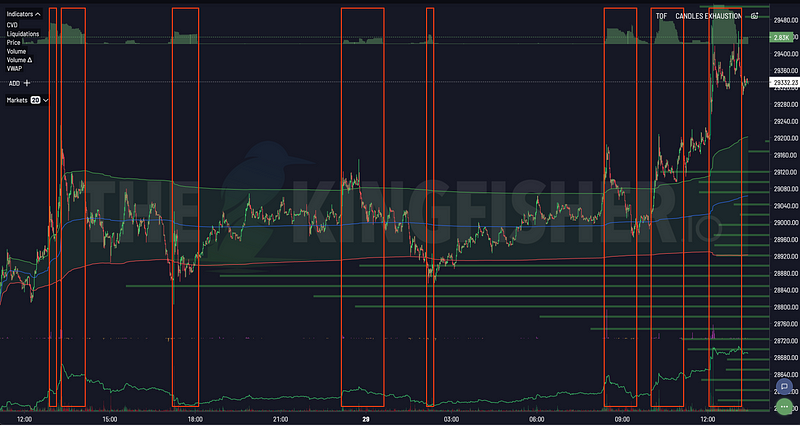
Jahrelang folgte die quantitative Analyse an Kryptomärkten einem einfachen Muster: Datenanbieter liefern Indikatoren, und Trader versuchen, daraus Entscheidungen abzuleiten. Wenn sich die Märkte beschleunigen, zeigt dieser Ansatz jedoch seine Grenzen. Zu wissen, wo sich Liquidationen konzentrieren, reicht nicht aus. Man muss auch verstehen, wie Aufträge mit diesem Niveau interagieren, ob die verfügbare Liquidität die Bewegung aufnehmen kann und wann eine vermeintliche Chance zum Risiko wird.
Bei TheKingfisher untersuchen wir diese Fragen seit mehreren Monaten. Unsere Forschung nutzt inzwischen autonome KI-Systeme, die Hypothesen formulieren, kontrollierte Experimente durchführen, Ergebnisse validieren und die Erkenntnisse jedes gescheiterten Experiments bewahren. Unser Ziel ist kein einzelnes KI-Modell, das behauptet, jede Marktbewegung vorherzusagen. Stattdessen zerlegen wir komplexe Marktprobleme in kleinere Mechanismen, messen ihren Nutzen und verbinden die stärksten Komponenten zu kompakten Risikomodellen.
Die Ergebnisse dieser Forschung stellen wir nun über unsere Angebote Premium und Pro bereit, zugänglich über unsere Oberflächen, API und MCP-Integrationen (Model Context Protocol). Das haben wir bisher gelernt.
In diesem Artikel
- Marktintuition in überprüfbare Forschung überführen
- Warum mehr Agenten nicht automatisch mehr Entdeckungen liefern
- Warum wir spezialisierte Modelle einem einzigen großen Prognosemodell vorziehen
- Schnellere Forschung erfordert strengere Validierung
- Die eigentliche Grenze automatisierten Handels: Ausführungskosten
- Eine neue Generation von Handelswerkzeugen, die Nutzer selbst bauen
- Welche Fragen offenbleiben
- Von Marktdaten zu quantitativer Intelligenz
Marktintuition in überprüfbare Forschung überführen
Eine KI eine Handelsstrategie erzeugen zu lassen, ist nicht dasselbe wie wissenschaftliche Forschung. Ein Modell kann irreführende Korrelationen entdecken, Parameter an historisches Rauschen anpassen oder Informationen einbeziehen, die beim Ausführen eines Trades noch nicht verfügbar gewesen wären. So entstehen beeindruckende Backtests mit geringem Vorhersagewert. Um diese Risiken zu reduzieren, entwickelten wir eine autonome Forschungsumgebung mit vier Grundsätzen.
Die Hypothese vor dem Experiment definieren
Jeder Forschungsagent muss den zu prüfenden Mechanismus, das erwartete Ergebnis und die Bedingungen erläutern, unter denen die Hypothese verworfen werden müsste. Das verhindert nachträglich erfundene Erklärungen für günstige Ergebnisse.
Änderungen isolieren
Verbessert ein Experiment die Leistung, müssen wir die Ursache kennen. Kontrollierte Änderungen verhindern, dass unabhängige Mechanismen in einem Experiment vermischt werden.
Jedes Ergebnis zu widerlegen versuchen
Unsere Experimente umfassen Negativkontrollen, eine chronologische Trennung der Daten und Tests mit Daten, die bei der Entwicklung nicht verwendet wurden. Ein vielversprechendes Signal muss auch unter anderen Bedingungen bestehen als jenen, unter denen es entdeckt wurde.
Entdeckung und Validierung trennen
Der Agent, der eine Hypothese vorschlägt, darf nicht allein entscheiden, ob sie funktioniert. Eine unabhängige Validierung untersucht Reproduzierbarkeit, Transaktionskosten, Slippage, Finanzierung und Marktbedingungen. Dieser Rahmen verändert die Rolle der KI in unserer Forschung.
KI ersetzt die wissenschaftliche Methode nicht. Sie ermöglicht uns, sie mit einheitlichen Validierungsregeln auf mehr Experimente anzuwenden.
Warum mehr Agenten nicht automatisch mehr Entdeckungen liefern
Eine unserer wichtigsten Erkenntnisse betrifft die Zusammenarbeit zwischen KI-Agenten. Mehr Agenten an einem Problem garantieren keine höhere Produktivität. Ohne Koordination wiederholen sie Experimente, verbreiten ungeprüfte Schlussfolgerungen und gelangen zu ähnlichen Ideen. Diese Grenzen beobachteten wir in unseren eigenen Forschungsreihen mit mehreren Agenten. Deshalb wechselten wir von unbeschränkten Gesprächen zwischen Agenten zu einer Architektur mit strukturierten Hypothesen und überprüfbaren Belegen.
Unser System bewahrt die Beziehungen zwischen Forschungsfragen, Experimenten, Beobachtungen und Schlussfolgerungen. Jede Erkenntnis lässt sich mit ihren Belegen verknüpfen. Für jede verworfene Hypothese bleibt dokumentiert, warum sie scheiterte. Das verändert die Zusammenarbeit: Statt abgeschlossene Experimente zu wiederholen, kann ein Agent auf früheren Ergebnissen aufbauen, offene Fragen erkennen und eine andere Richtung untersuchen. Wir haben zudem erforscht, wie unterschiedliche Denkfähigkeiten zusammenwirken können: Hypothesenbildung, kritische Bewertung und unabhängige Überprüfung.
Dieser Ansatz verringerte Doppelarbeit und steigerte die Effizienz unserer Versuchsreihen. Sein größter Nutzen geht jedoch tiefer:
Ein gescheitertes Experiment wird zu wiederverwendbarem Wissen.
Eine Strategie, die unter bestimmten Marktbedingungen scheitert, ein Filter, der zu viele Chancen entfernt, oder ein Modell, das nach Transaktionskosten seinen Vorteil verliert, liefert dennoch nützliche Informationen. Diese Ergebnisse zu bewahren hilft uns, dieselben Fehler nicht erneut zu entdecken. Mit der Zeit sammelt das System erfolgreiche Ideen und ein strukturiertes Verständnis dessen, was nicht funktioniert.
Warum wir spezialisierte Modelle einem einzigen großen Prognosemodell vorziehen
Kryptomärkte verbinden mehrere Prozesse mit unterschiedlichen Geschwindigkeiten. Das Orderbuch beschreibt die verfügbare Liquidität. Ausgeführte Trades zeigen den tatsächlichen Kauf- und Verkaufsdruck. Potenzielle Liquidationsniveaus markieren Bereiche, in denen Preisbewegungen erzwungene Marktaktivität auslösen können. Kein einzelner Indikator erfasst den gesamten Prozess. Unsere Forschung verfolgt deshalb einen modularen Ansatz: konkrete Probleme durch mathematische Transformationen oder kompakte Modelle lösen und anschließend ihr Zusammenspiel bewerten.
Das erleichtert die unabhängige Validierung, begrenzt Komplexität und ermöglicht den Austausch von Mechanismen, die bei veränderten Marktbedingungen nicht mehr funktionieren. Drei Bereiche verdeutlichen dies.
Orderflow im Zusammenhang mit Liquidationen verstehen
Indikatoren für Orderflow-Ungleichgewichte, darunter Kennzahlen wie VPIN, sollen potenziell toxische Handelsaktivität messen. Sie können Situationen erkennen helfen, in denen aggressive Transaktionen ungewöhnlichen Druck auf die Liquidität ausüben. Dasselbe Ungleichgewicht bedeutet jedoch nicht in jedem Marktumfeld dasselbe. Starker Verkaufsdruck in einem tiefen, liquiden Markt kann andere Folgen haben als vergleichbare Aktivität nahe einer Konzentration potenzieller Liquidationen.
Wir untersuchten deshalb, wie Liquidationsdaten die Interpretation von Orderflow verbessern können. Unsere Experimente deuten darauf hin, dass der Liquidationskontext den Nutzen bestimmter Mikrostruktursignale gegenüber ihrer isolierten Verwendung erhöhen kann. Das stützt einen wichtigen Grundsatz von TheKingfisher. Liquidationskarten sind mehr als visuelle Darstellungen des Marktgeschehens. Sie liefern Informationen, die sich mit anderen Marktdaten zur Bewertung von Risikoszenarien kombinieren lassen.
Warum gute Einstiegs- und Ausstiegsregeln zusammen schlecht funktionieren können
Eine Strategie kann ein nützliches Einstiegssignal und eine vernünftige Ausstiegsregel haben, ohne dass ihre Kombination gute Ergebnisse liefert. Der Grund ist die Ausführung. Ein Trade ist keine rein theoretische Entscheidung. Er muss durch ein echtes Orderbuch mit wechselnder Liquidität, Warteschlangenposition, Spreads und adverser Selektion ausgeführt werden. Unsere Experimente zeigten, dass manche Verbesserungen ihren Wert verloren, wenn sie ohne diese Ausführungsbedingungen kombiniert wurden.
Ein Signal kann beispielsweise eine attraktive Gelegenheit erkennen, während die Bedingungen der tatsächlichen Orderausführung das erwartete Ergebnis verändern. So kann adverse Selektion entstehen: Orders werden unter Bedingungen ausgeführt, die kurz danach ungünstig werden. Die Schlussfolgerung ist klar:
Ausführungsqualität ist Teil der Signalqualität.
Einstiegslogik, Ausstiegslogik, Risikomanagement und Orderplatzierung lassen sich nicht immer unabhängig optimieren. Sie müssen auch als Gesamtsystem bewertet werden.
Chancen erkennen, die ihren Vorteil verlieren
Nicht jeder Verlusttrade beginnt mit einer starken Bewegung gegen die Position. Manche Trades verschlechtern sich, weil die erwartete Bewegung ausbleibt. Eine zunächst attraktive Gelegenheit kann an Wert verlieren, wenn die Volatilität sinkt, sich die Liquidität verändert oder der Markt konsolidiert. Deshalb untersuchten wir schlanke Modelle, die bewerten, wie sich eine Gelegenheit nach dem Auftreten ihrer Ausgangsbedingungen entwickelt.
Statt jede künftige Preisbewegung vorherzusagen, helfen diese Modelle, Situationen zu erkennen, in denen eine Position ihr Risiko möglicherweise nicht mehr rechtfertigt. In historischen Validierungen reduzierte selektives Filtern das Engagement unter bestimmten ungünstigen Bedingungen und verbesserte die Ergebnisse der untersuchten Strategien. Diese Erkenntnisse hängen vom Prüfzeitraum, Marktumfeld und den Ausführungsannahmen ab. Sie zeigen dennoch den möglichen Nutzen mehrerer spezialisierter Modelle in einem abgestimmten Risikorahmen.
Schnellere Forschung erfordert strengere Validierung
Autonome Forschung ermöglicht mehr Hypothesen. Gleichzeitig entstehen mehr Fehlermöglichkeiten. Während der Entwicklung veranlassten uns Unterschiede zwischen historischen Simulationen und prospektiven Beobachtungen, unsere Softwarekontrollen und Validierungsverfahren zu verstärken. Die Untersuchungen bestätigten eine wichtige Lehre: Fehler bei Datenverarbeitung, Systemintegration oder Versuchskonfiguration können die scheinbare Leistung eines Modells verändern. Auch ein mathematisch korrektes Modell kann bei der Integration in ein größeres System unerwartetes Verhalten zeigen.
Deshalb erweiterten wir Konsistenzprüfungen, Anforderungen an die Reproduzierbarkeit und Vergleiche zwischen simulierten und beobachteten Ergebnissen. Unsere Forschungsumgebung verbessert auch ihre eigenen Werkzeuge. Numerische Optimierung, Laufzeitprofilierung und automatisierte Tests senken die Kosten neuer Hypothesenprüfungen. Dadurch können wir mehr Experimente durchführen und mehr Ressourcen für unabhängige Überprüfungen einsetzen. Schnellere Experimente führen aber nicht automatisch zu besseren Entdeckungen.
Forschungstempo zählt nur, wenn zugleich die Qualität der Belege steigt.
Die eigentliche Grenze automatisierten Handels: Ausführungskosten
Viele Handelsstrategien werden überwiegend anhand historischer Preise entwickelt und bewertet. Das hilft beim Erkunden von Ideen, beschreibt aber nicht vollständig, wie sich eine Strategie im Produktivbetrieb verhält. Zwischen Signalerkennung und Tradeausführung können mehrere Faktoren das Ergebnis verändern:
- Handelsgebühren und Geld-Brief-Spannen
- Slippage und verfügbare Liquidität
- Finanzierungskosten
- Ausführungslatenz und Position in der Orderwarteschlange
Eine vor diesen Kosten profitabel wirkende Strategie kann mit realistischen Ausführungsannahmen ihren Vorteil verlieren. Unsere Simulationen bestätigten die Empfindlichkeit mehrerer Ansätze gegenüber diesen Bedingungen. Sie zeigten auch mögliche Vorteile der Kombination von Liquidationsinformationen, Mikrostruktursignalen und Risikokontrollen. Das bedeutet nicht, dass ein Modell profitable Ausführung garantieren kann. Es bedeutet, dass ein Entscheidungssystem mehr als die scheinbare Chance bewerten muss.
Es muss auch die Kosten und Risiken berücksichtigen, die beim Handeln auf dieser Grundlage entstehen. Beim Übergang von Forschung zu realer Ausführung wird diese Unterscheidung wesentlich.
Eine neue Generation von Handelswerkzeugen, die Nutzer selbst bauen
KI-Programmierassistenten und Agentenprotokolle verändern die Softwareentwicklung im Trading. Entwickler und unabhängige Trader können mit weniger Entwicklungsaufwand individuelle Analysen erstellen, mehrere Datenquellen verbinden und Forschungsabläufe automatisieren. Das beschleunigt den Trend zur selbst gebauten Handelsinfrastruktur, also Do-It-Yourself (DIY). Nutzer können Werkzeuge auf Kontogröße, Risikogrenzen und Ausführungsanforderungen abstimmen. Einfachere Softwareentwicklung beseitigt jedoch nicht die grundlegenden Herausforderungen quantitativen Handels.
Trader benötigen weiterhin verlässliche Daten, validierte Hypothesen, wirksame Risikokontrollen und ein klares Verständnis der Ausführungsbedingungen. Hier soll TheKingfisher Mehrwert liefern. Unser Ziel ist keine weitere geschlossene Handelsplattform. Wir wollen eine quantitative Informationsebene bereitstellen, die sich in bestehende oder selbst entwickelte Werkzeuge integrieren lässt.
Risikointelligenz und Handelsausführung trennen
Unser Ansatz trennt zwei Verantwortlichkeiten.
TheKingfisher liefert analytische Intelligenz: Liquidationskarten, Mikrostrukturindikatoren, spezialisierte Risikosignale und Erkenntnisse aus unseren Forschungsmodellen.
Nutzer behalten die Kontrolle über die Ausführung: Handelsentscheidungen, Risikoparameter, Infrastruktur und Zugangsdaten zu Handelsplätzen.
So lassen sich unsere Daten in unterschiedliche Umgebungen integrieren, ohne eine bestimmte Handelsengine oder ein bestimmtes Ordermanagementsystem vorauszusetzen. Zudem sinkt die Notwendigkeit, sensible Ausführungsberechtigungen an externe Dienste zu übertragen.
API und MCP: Forschung für KI-Agenten zugänglich machen
Unsere Dienste sind über die TheKingfisher-Oberflächen zugänglich oder lassen sich per API und MCP-Unterstützung in externe Anwendungen integrieren. Entwickler können Liquidationsinformationen und Risikosignale für individuelle Dashboards, Warnsysteme, Forschungsumgebungen und automatisierte Analysen verwenden. MCP bietet eine standardisierte Schnittstelle, über die kompatible KI-Anwendungen externe Werkzeuge und Datenquellen nutzen können. Das eröffnet neue Möglichkeiten für autonome Forschung und quantitative Analyse.
Entwickler können spezialisierte Marktintelligenz an ihre vorhandenen Systeme anbinden, statt jede Komponente neu aufzubauen.
Offene und überprüfbare Infrastruktur
Wir bevorzugen einen Ansatz, bei dem Nutzer Integrationskomponenten prüfen und kontrollieren können. Open-Source-Software kann dabei eine wichtige Rolle spielen, besonders bei Konnektoren und Werkzeugen in der eigenen Umgebung des Traders. Transparenz erleichtert die Prüfung von Abhängigkeiten, den Umgang mit Zugangsdaten und das Verständnis der Orderübermittlung. Nutzer sollten aus unserer Sicht die Kontrolle über Zugangsdaten, Berechtigungen und Ausführungssysteme behalten.
Marktintelligenz sollte zugänglich sein, ohne dass Trader diese Kontrolle abgeben müssen.
Welche Fragen offenbleiben
Unsere Forschung hat nützliche Muster identifiziert, aber auch die starke Abhängigkeit der Ergebnisse von Marktbedingungen gezeigt. Manche Signale verlieren bei lang anhaltender Volatilitätskompression an Informationswert. Andere verschlechtern sich bei veränderter Liquidität oder höheren Ausführungskosten. Diese Übergänge zu erkennen, Risikomodelle anzupassen und Unsicherheit zu messen bleibt eine wichtige Forschungsaufgabe. Wir untersuchen außerdem weiter, wie sich die Zusammenarbeit mehrerer Agenten, die Validierung und die Kombination spezialisierter Modelle verbessern lassen, ohne deren einzelne Vorteile zu verlieren.
Das Ziel ist keine universelle Handelsstrategie. Es ist ein Forschungsprozess, der Hypothesen erzeugt, prüft, schwache Ideen verwirft und die Qualität seiner Schlussfolgerungen verbessert. Ein Prozess, der sich an gescheiterte Experimente erinnert, eigene Grenzen erkennt und seine Annahmen fortlaufend hinterfragt.
Von Marktdaten zu quantitativer Intelligenz
An Indikatoren mangelt es Kryptomärkten nicht. Entscheidend ist, welche Informationen unter welchen Bedingungen relevant sind und welche Risiken beim Handeln daraus entstehen. Daran arbeiten wir bei TheKingfisher. Unsere autonomen Forschungssysteme ermöglichen mehr Untersuchungen von Marktmechanismen, die Bewahrung experimenteller Belege und die Überführung validierter Erkenntnisse in spezialisierte Analysewerkzeuge.
Diese Fähigkeiten stellen wir nun über Premium und Pro, eigene Oberflächen, API und MCP-Integrationen bereit. Unsere Vision ist klar:
Tradern die Intelligenz für eigene Systeme geben, gestützt auf hochwertige Marktdaten, spezialisierte Risikomodelle und vollständige Kontrolle über die Ausführung.
Die Zukunft quantitativen Handels hängt möglicherweise nicht von einem immer größeren Prognosemodell ab. Vielleicht beruht sie auf besseren Daten, strengeren Experimenten und kleineren spezialisierten Modellen, die zusammenarbeiten.
Historische Ergebnisse, Simulationen und experimentelle Validierungen garantieren keine künftigen Ergebnisse. Die beschriebenen Modelle dienen der Marktanalyse und Risikobewertung, nicht als Handelsanweisungen.