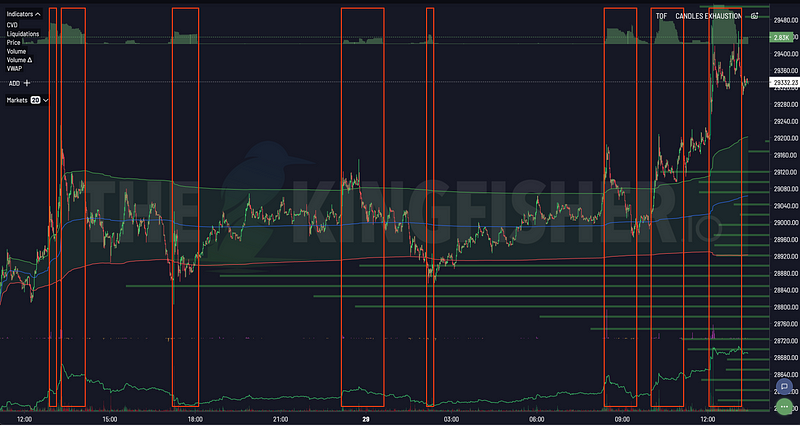
Pendant des années, l’analyse quantitative des marchés crypto a suivi une structure simple : les fournisseurs de données livrent des indicateurs, et les traders tentent de transformer ces informations en décisions. Mais lorsque les marchés accélèrent, cette approche révèle ses limites. Savoir où se trouve une concentration de liquidations ne suffit pas. Il faut aussi comprendre comment les ordres interagissent avec ce niveau, si la liquidité disponible peut absorber le mouvement et à quel moment une occasion apparente devient un risque.
Chez TheKingfisher, nous étudions ces questions depuis plusieurs mois. Notre recherche utilise désormais des systèmes d’IA autonomes qui formulent des hypothèses, mènent des expériences contrôlées, valident les résultats et conservent les enseignements de chaque expérience infructueuse. L’objectif n’est pas de construire un modèle d’IA unique qui prétendrait prédire tous les mouvements du marché. Nous décomposons plutôt les problèmes complexes en mécanismes plus petits, mesurons leur utilité et combinons les composants les plus solides dans des modèles de risque compacts.
Nous rendons désormais les résultats de cette recherche accessibles dans nos offres Premium et Pro, via nos interfaces, notre API et nos intégrations MCP (Model Context Protocol). Voici ce que nous avons appris.
Dans cet article
- Transformer l’intuition de marché en recherche vérifiable
- Pourquoi davantage d’agents ne produisent pas automatiquement davantage de découvertes
- Pourquoi nous privilégions les modèles spécialisés plutôt qu’un grand prédicteur unique
- Accélérer la recherche exige une validation plus rigoureuse
- La véritable contrainte du trading automatisé : les coûts d’exécution
- Une nouvelle génération d’outils de trading construits par leurs utilisateurs
- Les questions qui restent ouvertes
- Des données de marché à l’intelligence quantitative
Transformer l’intuition de marché en recherche vérifiable
Demander à un modèle d’IA de produire une stratégie de trading ne revient pas à mener une recherche scientifique. Un modèle peut découvrir des corrélations trompeuses, ajuster ses paramètres au bruit historique ou introduire des informations qui n’auraient pas été disponibles au moment de l’exécution d’une transaction. Ces erreurs peuvent produire des backtests impressionnants, mais peu prédictifs. Pour réduire ces risques, nous avons développé un environnement de recherche autonome fondé sur quatre principes.
Définir l’hypothèse avant l’expérience
Chaque agent de recherche doit expliquer le mécanisme qu’il veut tester, le résultat attendu et les conditions qui invalideraient son hypothèse. Cela évite que les agents inventent une explication après avoir observé des résultats favorables.
Isoler les changements
Lorsqu’une expérience améliore les performances, nous devons identifier la cause de cette amélioration. Des changements contrôlés permettent d’éviter de mélanger des mécanismes sans rapport dans une même expérience.
Chercher à réfuter chaque résultat
Nos expériences intègrent des contrôles négatifs, une séparation chronologique des données et des tests sur des données inutilisées pendant le développement. Un signal prometteur doit résister à des conditions différentes de celles dans lesquelles il a été découvert.
Séparer découverte et validation
L’agent qui propose une hypothèse ne doit pas être seul à décider si elle fonctionne. Une validation indépendante examine la reproductibilité, les coûts de transaction, le slippage, le financement et les contraintes du marché. Ce cadre transforme le rôle de l’IA dans notre recherche.
L’IA ne remplace pas la méthode scientifique. Elle nous permet de l’appliquer à davantage d’expériences, avec des règles de validation cohérentes.
Pourquoi davantage d’agents ne produisent pas automatiquement davantage de découvertes
L’un de nos principaux enseignements concerne la collaboration entre agents d’IA. Augmenter le nombre d’agents travaillant sur un problème ne garantit pas une meilleure productivité. Sans coordination, ils répètent les expériences, diffusent des conclusions non vérifiées et convergent vers des idées similaires. Nous avons observé ces limites pendant nos propres campagnes de recherche multi-agents. Pour y remédier, nous avons dépassé les conversations sans cadre entre agents et adopté une architecture fondée sur des hypothèses structurées et des preuves vérifiables.
Notre système conserve les relations entre questions de recherche, expériences, observations et conclusions. Chaque résultat peut être relié aux preuves qui l’étayent. Chaque hypothèse rejetée conserve une explication de son échec. Cela change la façon dont les agents collaborent. Au lieu de répéter une expérience déjà menée, un agent peut exploiter les résultats précédents, repérer les questions ouvertes et explorer une autre direction. Nous avons également étudié comment faire travailler ensemble différentes capacités de raisonnement : génération d’hypothèses, évaluation critique et vérification indépendante.
Cette approche a réduit les travaux redondants et amélioré l’efficacité de nos campagnes expérimentales. Son principal bénéfice est toutefois plus fondamental :
Une expérience infructueuse devient une connaissance réutilisable.
Une stratégie qui échoue dans certaines conditions de marché, un filtre qui élimine trop d’occasions ou un modèle qui perd son avantage une fois les coûts de transaction intégrés produisent malgré tout des informations utiles. Conserver ces résultats nous aide à éviter de redécouvrir les mêmes erreurs. Au fil du temps, le système accumule des idées efficaces, mais aussi une compréhension structurée de ce qui ne fonctionne pas.
Pourquoi nous privilégions les modèles spécialisés plutôt qu’un grand prédicteur unique
Les marchés crypto combinent plusieurs processus qui évoluent à des vitesses différentes. Le carnet d’ordres décrit la liquidité disponible. Les transactions exécutées révèlent les pressions acheteuses et vendeuses réelles. Les niveaux de liquidation potentiels indiquent les zones où un mouvement de prix pourrait déclencher une activité forcée. Aucun indicateur ne capture l’ensemble de ce processus. Notre recherche s’oriente donc vers une approche modulaire : résoudre des problèmes précis avec des transformations mathématiques ou des modèles compacts, puis évaluer le comportement de ces composants une fois combinés.
Cette approche facilite la validation indépendante des composants, la maîtrise de la complexité et le remplacement des mécanismes qui ne sont plus performants lorsque les conditions de marché changent. Trois domaines l’illustrent.
Comprendre le flux d’ordres dans le contexte des liquidations
Les indicateurs de déséquilibre du flux d’ordres, notamment des mesures comme le VPIN, cherchent à mesurer une activité de trading potentiellement toxique. Ils peuvent aider à repérer les situations où des transactions agressives exercent une pression inhabituelle sur la liquidité disponible. Mais un même déséquilibre n’a pas la même signification dans tous les environnements de marché. Une forte pression vendeuse sur un marché profond et liquide peut produire un résultat différent d’une activité similaire près d’une concentration de liquidations potentielles.
Nous avons donc étudié comment les données de liquidation peuvent améliorer l’interprétation du flux d’ordres. Nos expériences indiquent que le contexte des liquidations peut accroître l’utilité de certains signaux de microstructure par rapport à leur utilisation isolée. Cela conforte un principe important de TheKingfisher. Les cartes de liquidation ne sont pas de simples représentations visuelles de l’activité du marché. Elles apportent des informations que l’on peut combiner avec d’autres données pour évaluer des scénarios de risque.
Pourquoi de bonnes règles d’entrée et de sortie peuvent mal fonctionner ensemble
Une stratégie peut disposer d’un signal d’entrée utile et d’une règle de sortie raisonnable sans produire de bons résultats lorsque les deux sont combinés. La raison tient à l’exécution. Une transaction n’est pas seulement une décision théorique. Elle doit être exécutée dans un véritable carnet d’ordres, avec une liquidité, une position dans la file, des spreads et une sélection adverse qui évoluent. Nos expériences ont montré que certaines améliorations perdaient leur valeur lorsqu’elles étaient combinées sans tenir compte de ces contraintes.
Par exemple, un signal peut repérer une occasion intéressante, mais les conditions dans lesquelles l’ordre est exécuté peuvent modifier le résultat attendu. Cela peut créer une sélection adverse : les ordres sont exécutés dans des conditions qui deviennent défavorables peu après. La conclusion est simple :
La qualité d’exécution fait partie de la qualité du signal.
La logique d’entrée, la logique de sortie, la gestion du risque et le placement des ordres ne peuvent pas toujours être optimisés séparément. Ils doivent aussi être évalués comme un système complet.
Détecter les occasions qui perdent leur avantage
Toute transaction perdante ne commence pas par un mouvement brutal contre la position. Certaines se dégradent parce que le mouvement attendu ne se produit jamais. Une occasion initialement intéressante peut perdre sa valeur lorsque la volatilité se contracte, que la liquidité change ou que le marché entre en consolidation. Cela nous a conduits à étudier des modèles légers qui évaluent l’évolution d’une occasion après l’apparition de ses conditions initiales.
Au lieu de tenter de prédire tous les mouvements de prix futurs, ces modèles aident à repérer les situations où une position ne justifie peut-être plus son risque. Lors de validations historiques, un filtrage sélectif a réduit l’exposition à certaines conditions défavorables et amélioré les résultats des stratégies étudiées. Ces observations dépendent de la période d’évaluation, de l’environnement de marché et des hypothèses d’exécution. Elles montrent néanmoins l’intérêt potentiel de combiner plusieurs modèles spécialisés dans un cadre coordonné de gestion du risque.
Accélérer la recherche exige une validation plus rigoureuse
La recherche autonome permet d’explorer davantage d’hypothèses. Elle crée aussi davantage de possibilités d’erreur. Pendant le développement, des écarts entre simulations historiques et observations prospectives nous ont conduits à renforcer nos contrôles logiciels et nos procédures de validation. Ces investigations ont confirmé une leçon importante : des erreurs de traitement des données, d’intégration ou de configuration des expériences peuvent modifier les performances apparentes d’un modèle. Même lorsqu’un modèle mathématique est correct, son intégration dans un système plus large peut introduire des comportements inattendus.
Nous avons donc étendu nos contrôles de cohérence, nos exigences de reproductibilité et les comparaisons entre résultats simulés et observés. Notre environnement de recherche contribue aussi à améliorer ses propres outils. L’optimisation numérique, le profilage des calculs et les tests automatisés réduisent le coût de l’évaluation de nouvelles hypothèses. Ces améliorations nous permettent de mener davantage d’expériences et de consacrer plus de ressources à la vérification indépendante. Mais accélérer les expériences ne garantit pas de meilleures découvertes.
La vitesse de recherche ne compte que si la qualité des preuves progresse avec elle.
La véritable contrainte du trading automatisé : les coûts d’exécution
De nombreuses stratégies de trading sont développées et évaluées principalement à partir de prix historiques. Ces données sont utiles pour explorer des idées, mais elles ne peuvent pas décrire entièrement le comportement d’une stratégie en production. Entre la détection d’un signal et l’exécution d’une transaction, plusieurs facteurs peuvent modifier le résultat :
- Les frais de trading et les écarts acheteur-vendeur
- Le slippage et la liquidité disponible
- Les coûts de financement
- La latence d’exécution et la position dans la file d’ordres
Une stratégie apparemment rentable avant ces coûts peut perdre son avantage lorsque des hypothèses d’exécution réalistes sont intégrées. Nos campagnes de simulation ont confirmé la sensibilité de plusieurs approches à ces contraintes. Elles ont aussi montré les bénéfices potentiels d’une combinaison des informations de liquidation, des signaux de microstructure et des contrôles de risque. Cela ne signifie pas qu’un modèle puisse garantir une exécution rentable. Cela signifie qu’un système de décision doit évaluer davantage que l’occasion apparente.
Il doit aussi tenir compte du coût et du risque de l’action envisagée. Cette distinction devient essentielle lors du passage de la recherche à l’exécution réelle.
Une nouvelle génération d’outils de trading construits par leurs utilisateurs
Les assistants de programmation par IA et les protocoles pour agents transforment la façon dont les traders construisent leurs logiciels. Développeurs et traders indépendants peuvent désormais créer des analyses personnalisées, connecter plusieurs sources de données et automatiser leurs recherches avec moins de ressources techniques. Cela accélère le développement d’infrastructures de trading à construire soi-même, ou Do-It-Yourself (DIY). Les utilisateurs peuvent concevoir leurs outils en fonction de la taille de leurs comptes, de leurs limites de risque et de leurs exigences d’exécution. Mais simplifier le développement logiciel ne supprime pas les difficultés fondamentales du trading quantitatif.
Les traders ont toujours besoin de données fiables, d’hypothèses validées, de contrôles de risque efficaces et d’une compréhension claire des contraintes d’exécution. C’est là que nous souhaitons apporter de la valeur avec TheKingfisher. Notre objectif n’est pas d’imposer une nouvelle plateforme de trading fermée. Nous voulons fournir une couche d’intelligence quantitative intégrable aux outils que les utilisateurs possèdent déjà ou choisissent de construire.
Séparer l’analyse du risque de l’exécution des transactions
Notre approche distingue deux responsabilités.
TheKingfisher fournit l’intelligence analytique : cartes de liquidation, indicateurs de microstructure, signaux de risque spécialisés et enseignements issus de nos modèles de recherche.
Les utilisateurs gardent le contrôle de l’exécution : décisions de trading, paramètres de risque, infrastructure et identifiants d’accès aux plateformes d’échange.
Cette séparation permet d’intégrer nos données dans différents environnements sans imposer un moteur de trading ou un système de gestion des ordres particulier. Elle réduit aussi le besoin de déléguer des autorisations d’exécution sensibles à des services externes.
API et MCP : rendre la recherche accessible aux agents d’IA
Nos services sont accessibles dans les interfaces TheKingfisher ou intégrables à des applications externes grâce à notre API et à la prise en charge de MCP. Les développeurs peuvent utiliser les informations de liquidation et les signaux de risque dans des tableaux de bord personnalisés, des systèmes d’alerte, des environnements de recherche et des flux d’analyse automatisés. MCP fournit une interface standardisée permettant aux applications d’IA compatibles d’accéder à des outils et à des sources de données externes. Cela ouvre de nouvelles possibilités pour la recherche autonome et l’analyse quantitative.
Au lieu de reconstruire chaque composant, les développeurs peuvent connecter une intelligence de marché spécialisée à leurs systèmes existants.
Une infrastructure ouverte et auditable
Nous privilégions une approche dans laquelle les utilisateurs peuvent inspecter et contrôler les composants d’intégration. Les logiciels open source peuvent jouer un rôle important, notamment pour les connecteurs et outils exécutés dans l’environnement propre du trader. La transparence facilite l’examen des dépendances, la vérification de la gestion des identifiants et la compréhension de la soumission des ordres. Nous pensons que les utilisateurs doivent garder le contrôle de leurs identifiants, de leurs autorisations et de leurs systèmes d’exécution.
L’intelligence de marché doit rester accessible sans exiger des traders qu’ils abandonnent ce contrôle.
Les questions qui restent ouvertes
Notre recherche a identifié des régularités utiles, mais elle a aussi montré à quel point les performances dépendent des conditions du marché. Certains signaux deviennent moins informatifs pendant une compression prolongée de la volatilité. D’autres se dégradent lorsque la liquidité change ou que les coûts d’exécution augmentent. Détecter ces transitions, adapter les modèles de risque et mesurer l’incertitude restent des défis de recherche importants. Nous continuons également d’étudier comment améliorer la collaboration multi-agents, renforcer la validation et combiner des modèles spécialisés sans perdre leurs avantages individuels.
L’objectif n’est pas de découvrir une stratégie de trading universelle. Il est de construire un processus de recherche capable de générer des hypothèses, de les tester, de rejeter les idées fragiles et d’améliorer la qualité de ses conclusions. Un processus qui se souvient des expériences infructueuses, identifie ses propres limites et remet continuellement ses hypothèses en question.
Des données de marché à l’intelligence quantitative
Les marchés crypto ne manquent pas d’indicateurs. La difficulté consiste à déterminer quelles informations comptent, dans quelles conditions elles comptent et quels risques apparaissent lorsqu’on agit sur leur base. C’est ce que nous construisons chez TheKingfisher. Nos systèmes de recherche autonome nous permettent d’étudier davantage de mécanismes de marché, de conserver les preuves expérimentales et de transformer les résultats validés en outils analytiques spécialisés.
Nous rendons désormais ces capacités accessibles via nos offres Premium et Pro, nos interfaces dédiées, notre API et nos intégrations MCP. Notre vision est simple :
Donner aux traders l’intelligence nécessaire pour construire leurs propres systèmes, avec des données de marché de qualité, des modèles de risque spécialisés et un contrôle total sur l’exécution.
L’avenir du trading quantitatif ne dépendra peut-être pas de la construction d’un modèle de prédiction toujours plus grand. Il pourrait reposer sur de meilleures données, des expériences plus rigoureuses et des modèles spécialisés plus petits qui travaillent ensemble.
Les performances historiques, les simulations et les validations expérimentales ne garantissent pas les résultats futurs. Les modèles présentés ici servent à l’analyse de marché et à l’évaluation du risque, et ne constituent pas des instructions de trading.