Durante años, el análisis cuantitativo en los mercados cripto ha seguido una estructura sencilla: los proveedores entregan indicadores y los traders intentan convertir esa información en decisiones. Pero cuando el mercado acelera, este enfoque muestra sus límites. Saber dónde se concentra un grupo de liquidaciones no basta. También hay que entender cómo interactúan las órdenes con ese nivel, si la liquidez disponible puede absorber el movimiento y cuándo una oportunidad aparente se convierte en un riesgo.
En TheKingfisher llevamos varios meses investigando estas cuestiones. Nuestra investigación utiliza ahora sistemas de IA autónomos que formulan hipótesis, ejecutan experimentos controlados, validan resultados y conservan lo aprendido de cada experimento fallido. El objetivo no es construir un único modelo de IA que afirme predecir todos los movimientos del mercado. Dividimos los problemas complejos en mecanismos más pequeños, medimos su utilidad y combinamos los componentes más sólidos en modelos de riesgo compactos.
Ahora ofrecemos los resultados de esta investigación a través de nuestros planes Premium y Pro, con acceso desde nuestras interfaces, API e integraciones MCP (Model Context Protocol). Esto es lo que hemos aprendido.
En este artículo
- Convertir la intuición de mercado en investigación verificable
- Por qué más agentes no producen automáticamente más descubrimientos
- Por qué preferimos modelos especializados a un único gran predictor
- Investigar más rápido exige una validación más rigurosa
- La verdadera restricción del trading automatizado: los costes de ejecución
- Una nueva generación de herramientas de trading creadas por sus usuarios
- Lo que sigue sin resolverse
- De los datos de mercado a la inteligencia cuantitativa
Convertir la intuición de mercado en investigación verificable
Pedir a un modelo de IA que genere una estrategia de trading no equivale a realizar investigación científica. Un modelo puede encontrar correlaciones engañosas, ajustar parámetros al ruido histórico o incorporar información que no habría estado disponible al ejecutar una operación. Estos errores pueden producir backtests impresionantes con escaso valor predictivo. Para reducir estos riesgos, desarrollamos un entorno de investigación autónoma basado en cuatro principios.
Definir la hipótesis antes del experimento
Cada agente debe explicar el mecanismo que quiere probar, el resultado esperado y las condiciones que invalidarían la hipótesis. Esto impide inventar explicaciones después de observar resultados favorables.
Aislar los cambios
Cuando un experimento mejora el rendimiento, debemos identificar la causa. Los cambios controlados ayudan a evitar que mecanismos no relacionados se mezclen en un mismo experimento.
Intentar refutar cada resultado
Nuestros experimentos incluyen controles negativos, separación cronológica de los datos y pruebas con datos no utilizados durante el desarrollo. Una señal prometedora debe resistir condiciones distintas de aquellas en las que se descubrió.
Separar descubrimiento y validación
El agente que propone una hipótesis no debe ser la única autoridad que decide si funciona. La validación independiente examina reproducibilidad, costes de transacción, deslizamiento, financiación y restricciones del mercado. Este marco cambia el papel de la IA en nuestra investigación.
La IA no sustituye al método científico. Nos permite aplicarlo a más experimentos con reglas de validación coherentes.
Por qué más agentes no producen automáticamente más descubrimientos
Uno de nuestros hallazgos más importantes se refiere a la colaboración entre agentes de IA. Aumentar el número de agentes no garantiza mayor productividad. Sin coordinación, repiten experimentos, propagan conclusiones no verificadas y convergen en ideas similares. Observamos estas limitaciones en nuestras campañas de investigación multiagente. Para resolverlas, pasamos de las conversaciones sin restricciones a una arquitectura basada en hipótesis estructuradas y pruebas verificables.
Nuestro sistema conserva las relaciones entre preguntas de investigación, experimentos, observaciones y conclusiones. Cada hallazgo puede vincularse a las pruebas que lo respaldan. Cada hipótesis rechazada conserva una explicación de por qué falló. Esto cambia la colaboración: en lugar de repetir experimentos terminados, un agente puede aprovechar los resultados anteriores, identificar preguntas abiertas y explorar otra dirección. También investigamos cómo combinar distintas capacidades de razonamiento: generación de hipótesis, evaluación crítica y verificación independiente.
Este enfoque redujo el trabajo redundante y mejoró la eficiencia de nuestras campañas experimentales. Pero su mayor beneficio es más fundamental:
Un experimento fallido se convierte en conocimiento reutilizable.
Una estrategia que falla en ciertas condiciones, un filtro que elimina demasiadas oportunidades o un modelo que pierde su ventaja al incluir los costes de transacción siguen produciendo información útil. Conservar estos resultados evita redescubrir los mismos errores. Con el tiempo, el sistema acumula ideas exitosas y una comprensión estructurada de lo que no funciona.
Por qué preferimos modelos especializados a un único gran predictor
Los mercados cripto combinan procesos que operan a distintas velocidades. El libro de órdenes describe la liquidez disponible. Las operaciones ejecutadas revelan la presión compradora y vendedora real. Los niveles de liquidación potencial indican zonas donde el precio puede desencadenar actividad forzada. Ningún indicador captura el proceso completo. Por eso nuestra investigación avanza hacia un enfoque modular: resolver problemas específicos con transformaciones matemáticas o modelos compactos y evaluar cómo se comportan al combinarlos.
Así resulta más fácil validar componentes por separado, controlar la complejidad y sustituir mecanismos que dejan de funcionar cuando cambia el mercado. Tres áreas ilustran este enfoque.
Entender el flujo de órdenes en el contexto de las liquidaciones
Los indicadores de desequilibrio del flujo de órdenes, incluidas métricas como VPIN, intentan medir actividad de trading potencialmente tóxica. Ayudan a identificar situaciones en las que las operaciones agresivas presionan de forma inusual la liquidez disponible. Pero un mismo desequilibrio no significa lo mismo en todos los mercados. Una fuerte presión vendedora en un mercado profundo y líquido puede producir un resultado distinto de una actividad similar cerca de una concentración de liquidaciones potenciales.
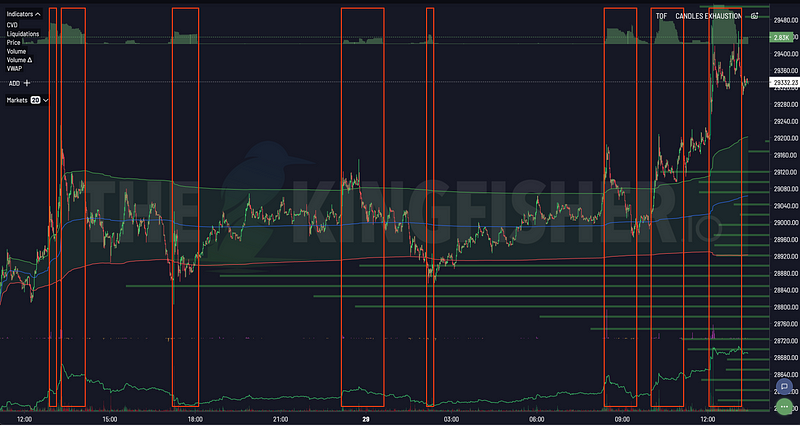
Investigamos cómo los datos de liquidación pueden mejorar la interpretación del flujo de órdenes. Nuestros experimentos indican que el contexto de liquidación puede aumentar la utilidad de ciertas señales de microestructura frente a su uso independiente. Esto respalda un principio importante de TheKingfisher. Los mapas de liquidación no son solo representaciones visuales de la actividad del mercado. Aportan información que puede combinarse con otros datos para evaluar escenarios de riesgo.
Por qué buenas reglas de entrada y salida pueden funcionar mal juntas
Una estrategia puede tener una señal de entrada útil y una regla de salida razonable sin producir buenos resultados al combinarlas. La razón es la ejecución. Una operación no es solo una decisión teórica: debe ejecutarse en un libro de órdenes real, con liquidez, posición en la cola, diferenciales y selección adversa cambiantes. Nuestros experimentos mostraron que algunas mejoras perdían valor al combinarlas sin considerar estas restricciones.
Por ejemplo, una señal puede identificar una oportunidad atractiva, pero las condiciones en las que se ejecuta la orden pueden cambiar el resultado esperado. Esto puede crear selección adversa: las órdenes se ejecutan en condiciones que se vuelven desfavorables poco después. La conclusión es sencilla:
La calidad de ejecución forma parte de la calidad de la señal.
La lógica de entrada, la de salida, la gestión del riesgo y la colocación de órdenes no siempre pueden optimizarse por separado. También deben evaluarse como un sistema completo.
Detectar oportunidades que pierden su ventaja
No toda operación perdedora comienza con un movimiento brusco contra la posición. Algunas se deterioran porque el movimiento esperado nunca llega. Una oportunidad inicialmente atractiva puede perder valor cuando la volatilidad se contrae, cambia la liquidez o el mercado entra en consolidación. Esto nos llevó a investigar modelos ligeros que evalúan cómo evoluciona una oportunidad tras aparecer sus condiciones iniciales.
En lugar de predecir cada movimiento futuro del precio, estos modelos ayudan a detectar situaciones en las que una posición quizá ya no justifique su riesgo. En la validación histórica, el filtrado selectivo redujo la exposición a ciertas condiciones desfavorables y mejoró los resultados de las estrategias estudiadas. Estos hallazgos dependen del periodo de evaluación, el entorno y las hipótesis de ejecución. Aun así, muestran el valor potencial de combinar modelos especializados en un marco de riesgo coordinado.
Investigar más rápido exige una validación más rigurosa
La investigación autónoma permite explorar más hipótesis. También crea más oportunidades de error. Durante el desarrollo, las diferencias entre simulaciones históricas y observaciones prospectivas nos llevaron a reforzar los controles de software y la validación. Estas investigaciones confirmaron una lección importante: los errores de tratamiento de datos, integración o configuración pueden alterar el rendimiento aparente de un modelo. Incluso si el modelo matemático es correcto, integrarlo en un sistema mayor puede introducir comportamientos inesperados.
Ampliamos los controles de coherencia, los requisitos de reproducibilidad y las comparaciones entre resultados simulados y observados. Nuestro entorno de investigación también mejora sus propias herramientas. La optimización numérica, el análisis del rendimiento computacional y las pruebas automatizadas reducen el coste de evaluar nuevas hipótesis. Esto permite ejecutar más experimentos y dedicar más recursos a la verificación independiente. Pero experimentar más rápido no garantiza mejores descubrimientos.
La velocidad de investigación solo importa si la calidad de las pruebas mejora con ella.
La verdadera restricción del trading automatizado: los costes de ejecución
Muchas estrategias se desarrollan y evalúan principalmente con precios históricos. Esto permite explorar ideas, pero no describe por completo cómo se comportarán en producción. Entre detectar una señal y ejecutar una operación, varios factores pueden cambiar el resultado:
- Comisiones y diferenciales entre compra y venta
- Deslizamiento y liquidez disponible
- Costes de financiación
- Latencia de ejecución y posición en la cola de órdenes
Una estrategia aparentemente rentable antes de estos costes puede perder su ventaja con hipótesis de ejecución realistas. Nuestras simulaciones confirmaron que varios enfoques son sensibles a estas restricciones. También mostraron los beneficios potenciales de combinar información de liquidaciones, señales de microestructura y controles de riesgo. Esto no significa que un modelo pueda garantizar una ejecución rentable. Significa que un sistema de decisión debe evaluar algo más que la oportunidad aparente.
También debe considerar el coste y el riesgo de actuar sobre ella. Esta distinción es esencial al pasar de la investigación a la ejecución real.
Una nueva generación de herramientas de trading creadas por sus usuarios
Los asistentes de programación con IA y los protocolos de agentes están cambiando cómo se construye software para trading. Desarrolladores y traders independientes pueden crear análisis personalizados, conectar varias fuentes y automatizar la investigación con menos recursos de ingeniería. Esto acelera el avance de la infraestructura de trading creada por el propio usuario, o Do-It-Yourself (DIY). Los usuarios pueden diseñar herramientas para el tamaño de sus cuentas, sus límites de riesgo y sus necesidades de ejecución. Pero facilitar el desarrollo no elimina los retos fundamentales del trading cuantitativo.
Los traders siguen necesitando datos fiables, hipótesis validadas, controles de riesgo eficaces y una comprensión clara de las restricciones de ejecución. Ahí queremos aportar valor con TheKingfisher. Nuestro objetivo no es imponer otra plataforma cerrada. Queremos ofrecer una capa de inteligencia cuantitativa integrable en las herramientas que los usuarios ya utilizan o decidan construir.
Separar la inteligencia de riesgo de la ejecución de operaciones
Nuestro enfoque separa dos responsabilidades.
TheKingfisher proporciona inteligencia analítica: mapas de liquidación, indicadores de microestructura, señales de riesgo especializadas y conocimientos derivados de nuestros modelos de investigación.
Los usuarios conservan el control de la ejecución: sus decisiones, parámetros de riesgo, infraestructura y credenciales de las plataformas de intercambio.
Esta separación permite integrar nuestros datos en distintos entornos sin exigir un motor de trading ni un sistema de gestión de órdenes concreto. También reduce la necesidad de delegar permisos de ejecución sensibles en servicios externos.
API y MCP: hacer accesible la investigación a los agentes de IA
Se puede acceder a nuestros servicios desde las interfaces de TheKingfisher o integrarlos en aplicaciones externas mediante nuestra API y compatibilidad con MCP. Los desarrolladores pueden utilizar información de liquidaciones y señales de riesgo en paneles personalizados, alertas, entornos de investigación y análisis automatizados. MCP proporciona una interfaz estandarizada para que las aplicaciones de IA compatibles accedan a herramientas y fuentes de datos externas. Esto abre nuevas posibilidades para la investigación autónoma y el análisis cuantitativo.
En lugar de reconstruir cada componente, los desarrolladores pueden conectar inteligencia de mercado especializada a sus sistemas existentes.
Infraestructura abierta y auditable
Preferimos un enfoque en el que los usuarios puedan inspeccionar y controlar los componentes de integración. El software de código abierto puede desempeñar un papel importante, especialmente en conectores y herramientas que se ejecutan en el entorno del trader. La transparencia facilita revisar dependencias, comprobar cómo se gestionan las credenciales y entender cómo se envían las órdenes. Creemos que los usuarios deben conservar el control de sus credenciales, permisos y sistemas de ejecución.
La inteligencia de mercado debe ser accesible sin exigir a los traders que renuncien a ese control.
Lo que sigue sin resolverse
Nuestra investigación ha identificado patrones útiles, pero también ha mostrado cuánto depende el rendimiento de las condiciones del mercado. Algunas señales aportan menos información durante una compresión prolongada de la volatilidad. Otras se deterioran cuando cambia la liquidez o aumentan los costes de ejecución. Detectar estas transiciones, adaptar los modelos y medir la incertidumbre siguen siendo retos importantes. También investigamos cómo mejorar la colaboración multiagente, reforzar la validación y combinar modelos especializados sin perder sus ventajas individuales.
El objetivo no es descubrir una estrategia universal. Es construir un proceso capaz de generar hipótesis, probarlas, rechazar ideas débiles y mejorar la calidad de sus conclusiones. Un proceso que recuerde los experimentos fallidos, identifique sus limitaciones y cuestione continuamente sus supuestos.
De los datos de mercado a la inteligencia cuantitativa
A los mercados cripto no les faltan indicadores. El reto es determinar qué información importa, en qué condiciones y qué riesgos surgen al actuar sobre ella. Eso es lo que construimos en TheKingfisher. Nuestros sistemas de investigación autónoma permiten estudiar más mecanismos de mercado, preservar pruebas experimentales y transformar hallazgos validados en herramientas analíticas especializadas.
Ahora hacemos accesibles estas capacidades mediante nuestros planes Premium y Pro, interfaces dedicadas, API e integraciones MCP. Nuestra visión es sencilla:
Dar a los traders la inteligencia necesaria para construir sus propios sistemas, con datos de mercado de calidad, modelos de riesgo especializados y pleno control de la ejecución.
El futuro del trading cuantitativo quizá no dependa de construir un modelo predictivo cada vez más grande. Puede depender de mejores datos, experimentos más sólidos y modelos especializados más pequeños que trabajen juntos.
El rendimiento histórico, las simulaciones y la validación experimental no garantizan resultados futuros. Los modelos descritos se destinan al análisis de mercado y la evaluación del riesgo, no a dar instrucciones de trading.